گزارش چهار ماهه استفاده از APIهای هوش مصنوعی سپیدور؛ بیش از ۲۵۳ میلیارد توکن در مسیر توسعه
از ۴۹ میلیون درخواست API تا پردازش بیش از ۲۵۳ میلیارد توکن؛ نگاهی به الگوی استفاده از مدلهای زبانی بزرگ (LLM) در زیرساخت هوش مصنوعی سپیدور

هوش مصنوعی دیگر صرفاً ابزاری برای آزمایش و تجربه نیست. امروز کسبوکارها، تیمهای فنی و توسعهدهندگان از مدلهای زبانی بزرگ (LLM) برای پاسخگویی به کاربران، تولید محتوا، تحلیل داده، برنامهنویسی و خودکارسازی فرایندها استفاده میکنند. در این میان، APIهای مدل زبانی به یکی از راهکارهای اصلی برای اتصال نرمافزارها و محصولات دیجیتال به مدلهای هوشمند تبدیل شدهاند.
گسترش این کاربردها، نیاز به زیرساختی را افزایش داده است که دسترسی به مدلهای زبانی بزرگ (LLM) و سایر مدلهای زبانی را سادهتر و قابلاستفادهتر کند.
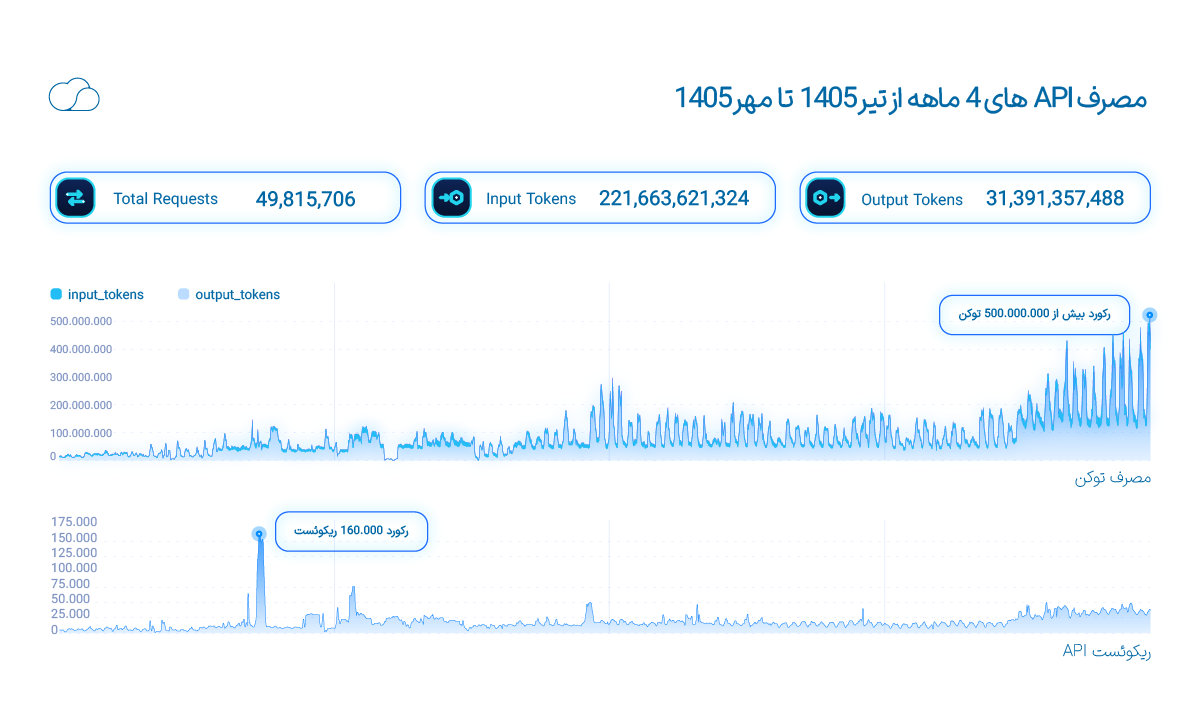
سپیدور در گزارش عملکرد چهار ماهه سرویس API مدلهای زبانی خود، از ابتدای تیر تا پایان مهر ۱۴۰۵، تصویری از میزان استفاده از این زیرساخت ارائه کرده است. بر اساس این گزارش، در این دوره بیش از ۴۹.۸ میلیون درخواست API ثبت شده و مجموع توکنهای ورودی و خروجی از ۲۵۳ میلیارد عبور کرده است.
این آمار علاوه بر نمایش حجم پردازش انجامشده، تصویری از مدلهای پرکاربرد هوش مصنوعی، ساعات اوج استفاده از API و حوزههایی ارائه میدهد که توسعهدهندگان بیشترین بهره را از مدلهای زبانی و قابلیتهای AI بردهاند.
فهرست مطالب۸ بخش
- ۱۲۵۳ میلیارد توکن در چهار ماه؛ حجم استفاده از API هوش مصنوعی سپیدور چقدر بوده است؟
- ۲کدام مدلهای زبانی بزرگ (LLM) بیشترین استفاده را داشتهاند؟
- ۳بیشترین تعداد درخواستهای API متعلق به کدام مدل است؟
- ۴چه زمانی بیشترین استفاده از APIهای AI ثبت میشود؟
- ۵هوش مصنوعی بیشتر برای چه کارهایی استفاده میشود؟
- ۶از دستیار گفتوگو تا تحلیل داده؛ مدلهای زبانی بزرگ چه نقشی در محصولات دارند؟
- ۷API؛ راهی برای استفاده از هوش مصنوعی بدون راهاندازی زیرساخت پردازشی اختصاصی
- ۸سپیدور؛ زیرساختی برای دسترسی سادهتر به مدلهای هوش مصنوعی
۲۵۳ میلیارد توکن در چهار ماه؛ حجم استفاده از API هوش مصنوعی سپیدور چقدر بوده است؟
بر اساس آمار ثبتشده، سرویس API هوش مصنوعی سپیدور در چهار ماه مورد بررسی، مجموعاً ۴۹ میلیون و ۸۱۵ هزار و ۷۰۶ درخواست را پردازش کرده است.
در این بازه، مجموع توکنهای ورودی به بیش از ۲۲۱.۶ میلیارد و توکنهای خروجی به بیش از ۳۱.۳ میلیارد رسیده است. مجموع این دو، حجم پردازش بیش از ۲۵۳ میلیارد توکن را نشان میدهد.
توکن ورودی به دادههایی گفته میشود که کاربر یا برنامه از طریق API به مدل زبانی ارسال میکند؛ از جمله متن پرسش، دستورالعملها، محتوای اسناد و اطلاعات زمینهای. در مقابل، توکن خروجی شامل محتوایی است که مدلهای زبانی بزرگ (LLM) در پاسخ تولید میکنند.
این تفکیک اهمیت زیادی دارد؛ چرا که در کنار تعداد درخواستهای API، حجم ورودی نشاندهنده میزان اطلاعاتی است که برای پردازش در اختیار مدلهای زبانی بزرگ (LLM) قرار گرفته و حجم خروجی، میزان محتوای تولید شده توسط آنها را نشان میدهد.
کدام مدلهای زبانی بزرگ (LLM) بیشترین استفاده را داشتهاند؟
تنوع مدلهای زبانی بزرگ (LLM) یکی از عوامل مهم در توسعه کاربردهای AI است. هر مدل با توجه به تواناییها، سرعت و نوع پردازش، میتواند برای مجموعهای از نیازهای کسبوکارها و توسعهدهندگان مناسب باشد.
بررسی آمار مصرف API سپیدور نشان میدهد سه مدل Gemma4-31، DeepSeek-V4-Flash و Qwen3.8-27 بیشترین سهم را از مصرف ثبتشده داشتهاند.
در رتبه نخست، مدل Gemma4-31 با سهم ۶۹.۵ درصدی از مجموع توکنهای مصرفشده قرار دارد. پس از آن DeepSeek-V4-Flash با سهم ۲۱.۷ درصد و Qwen3.8-27 با سهم ۸.۷ درصد قرار گرفتهاند.
این توزیع نشان میدهد که بخش عمده مصرف توکن در این بازه به Gemma4-31 اختصاص داشته است؛ درحالیکه دو مدل دیگر نیز سهم قابلتوجهی از پردازشهای انجامشده از طریق API هوش مصنوعی سپیدور را به خود اختصاص دادهاند.
بیشترین تعداد درخواستهای API متعلق به کدام مدل است؟
وقتی معیار مقایسه از حجم توکن به تعداد درخواستها تغییر میکند، همچنان Gemma4-31 در رتبه نخست قرار میگیرد.
بر اساس گزارش سپیدور، حدود ۴۶ میلیون درخواست از مجموع درخواستهای ثبتشده مربوط به این مدل بوده است. این عدد معادل حدود ۹۰ درصد کل درخواستها است.
DeepSeek-V4-Flash با حدود ۳ میلیون درخواست و سهم ۵.۹ درصدی در جایگاه دوم قرار دارد. Qwen3.8-27 نیز با حدود ۲.۱ میلیون درخواست و سهم ۴.۱ درصدی، رتبه سوم را به خود اختصاص داده است.
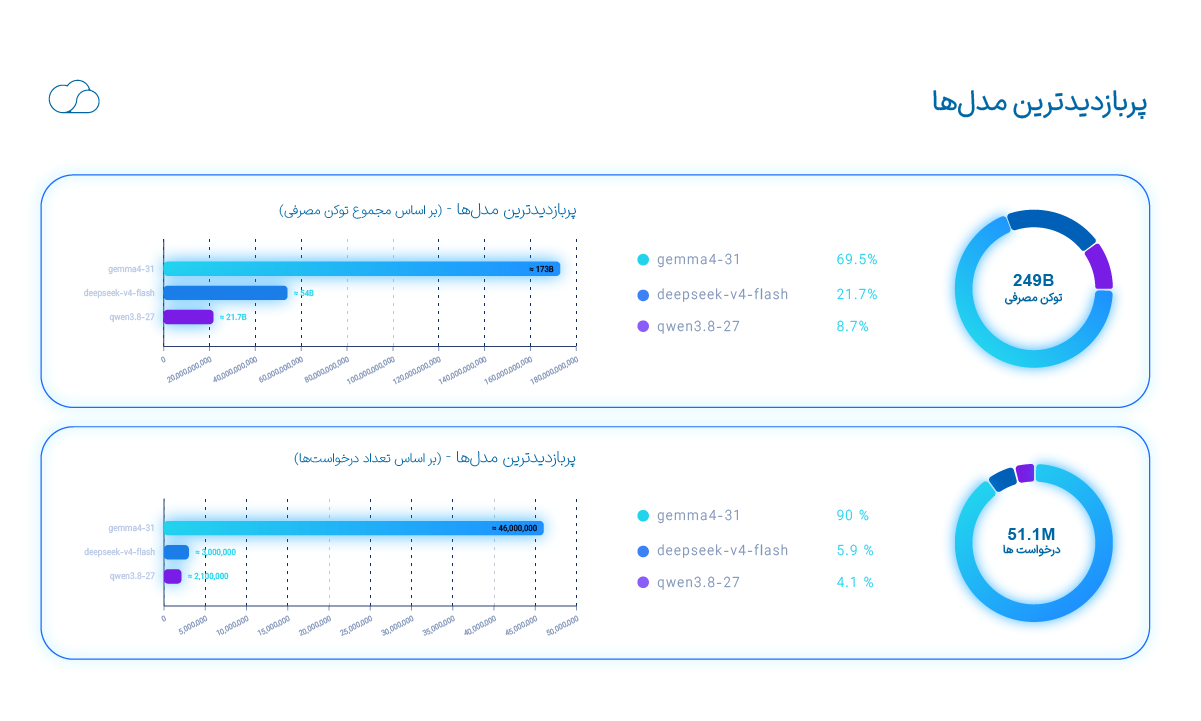
این مقایسه نشان میدهد که Gemma4-31 هم از نظر تعداد درخواستهای API و هم از نظر حجم توکن مصرفی، پرکاربردترین مدل زبانی در دوره مورد بررسی بوده است.
چه زمانی بیشترین استفاده از APIهای AI ثبت میشود؟
الگوی استفاده از سرویسهای AI در تمام ساعات شبانهروز یکسان نیست. بررسی توزیع بار مصرف API سپیدور در طول ۲۴ ساعت نشان میدهد که فعالیت کاربران از ساعات ابتدایی صبح افزایش پیدا میکند و در طول روز به بیشترین میزان خود میرسد.
بر اساس دادههای گزارش، بار مصرف از حدود ساعت ۶ صبح روند افزایشی دارد و در فاصله ساعت ۹ تا ۱۶ در بالاترین سطح قرار میگیرد. نقطه اوج مصرف روزانه نیز حوالی ساعت ۱۵ ثبت شده است.
در این بازه، مصرف در بیشتر ساعات بالاتر از ۸۵ درصد اوج روزانه قرار دارد. پس از ساعت ۱۷، بار مصرف بهتدریج کاهش پیدا میکند و در ساعات پایانی شب به حدود یکچهارم اوج روزانه میرسد.
کمترین میزان مصرف نیز در فاصله ساعت ۲ تا ۴ بامداد ثبت شده است.
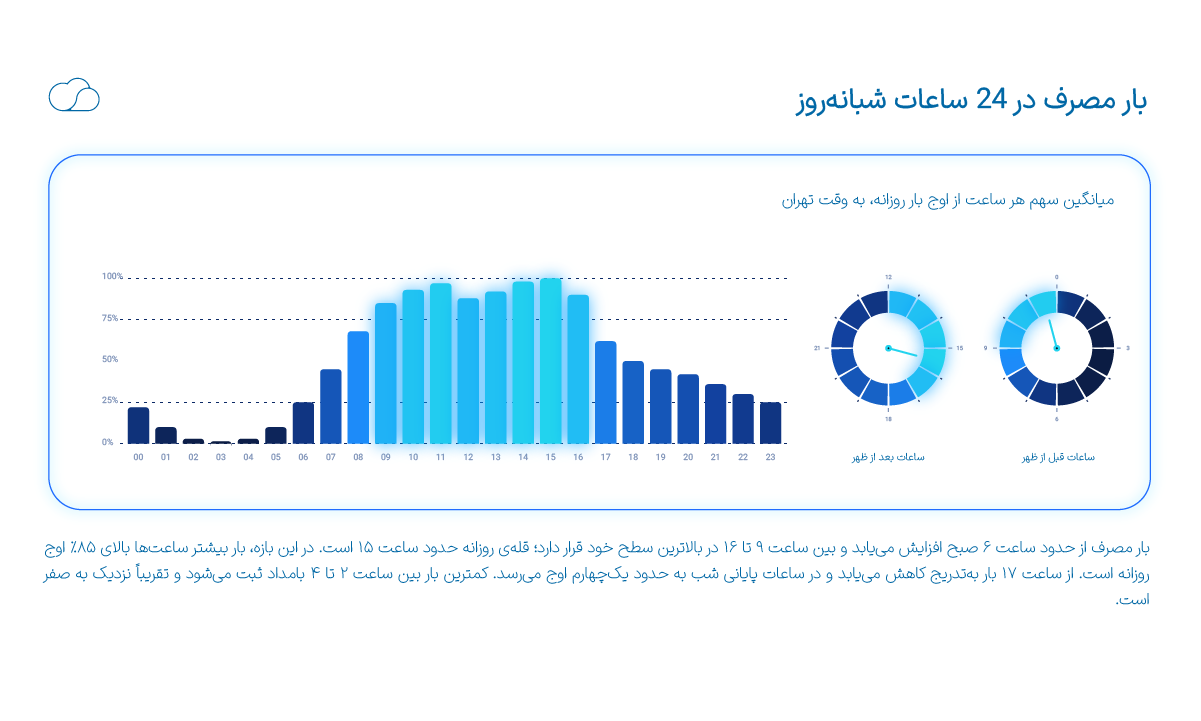
این الگو میتواند برای شناخت زمانهای پرترافیک و برنامهریزی ظرفیت زیرساختهای پردازشی اهمیت داشته باشد؛ بهویژه برای کسبوکارهایی که از API مدل زبانی و قابلیتهای AI در ساعات کاری برای ارائه خدمات به کاربران خود استفاده میکنند.
هوش مصنوعی بیشتر برای چه کارهایی استفاده میشود؟
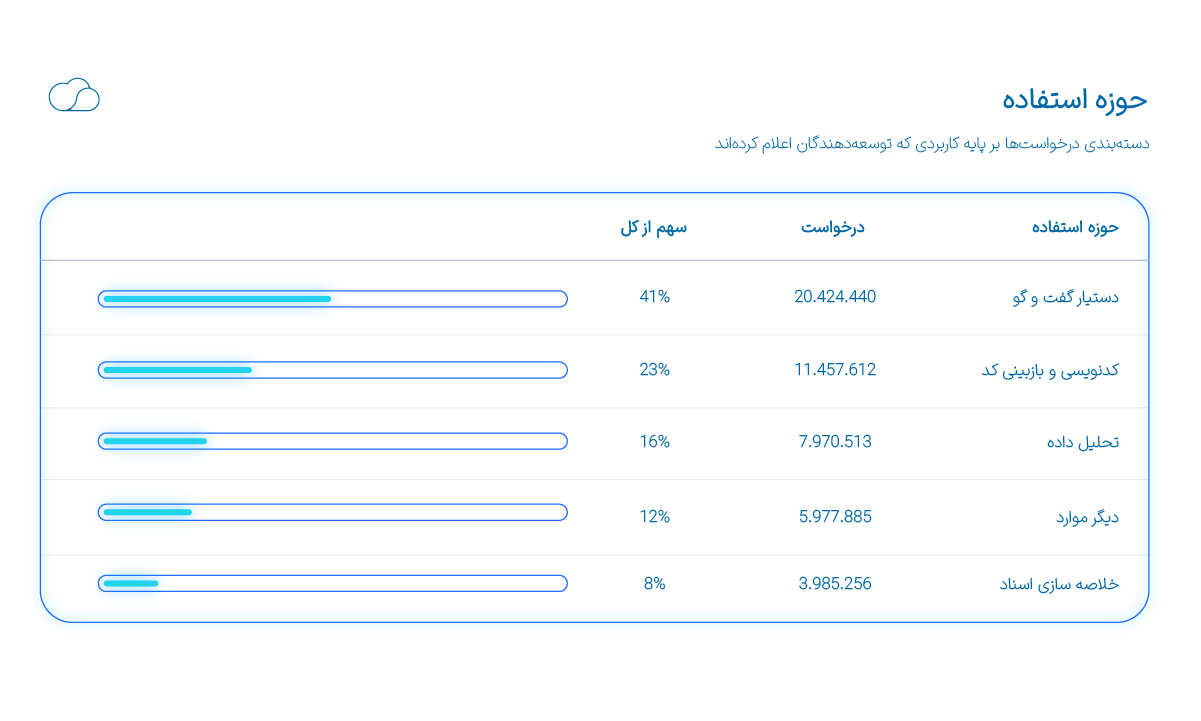
تعداد درخواستهای API بهتنهایی نمیتواند نشان دهد AI چه نقشی در فرایندهای واقعی کسبوکارها پیدا کرده است. برای درک بهتر این موضوع، دستهبندی درخواستها بر اساس کاربرد اعلامشده توسط توسعهدهندگان، تصویر دقیقتری از نیازهای کاربران ارائه میکند.
در گزارش چهارماهه سپیدور، دستیار گفتوگو با سهم ۴۱ درصدی، بیشترین میزان استفاده را به خود اختصاص داده است. پس از آن، کدنویسی و بازبینی کد با سهم ۲۳ درصد و تحلیل داده با سهم ۱۶ درصد قرار دارند.
سایر کاربردها نیز ۱۲ درصد از درخواستها را شامل میشوند و خلاصهسازی اسناد با سهم ۸ درصد در این دستهبندی قرار گرفته است.
از دستیار گفتوگو تا تحلیل داده؛ مدلهای زبانی بزرگ چه نقشی در محصولات دارند؟
سهم بالای دستیارهای گفتوگو نشان میدهد که یکی از کاربردهای مهم مدلهای زبانی بزرگ (LLM)، ایجاد تجربههای تعاملی برای کاربران است. کسبوکارها میتوانند با استفاده از APIهای هوش مصنوعی برای پاسخگویی خودکار، طراحی چتبات، پشتیبانی مشتریان و دسترسی سریعتر به اطلاعات اقدام کنند.
از طرف دیگر، سهم ۲۳ درصدی کدنویسی و بازبینی کد نشان میدهد که ابزارهای مبتنی بر AI در فرایند توسعه نرمافزار نیز کاربرد قابلتوجهی دارند. بررسی کد، پیشنهاد اصلاحات، توضیح بخشهای پیچیده و کمک به تولید کد از جمله قابلیتهایی هستند که میتوان با اتصال به API مدلهای زبانی در ابزارهای توسعه پیادهسازی کرد.
تحلیل داده و خلاصهسازی اسناد نیز دو حوزه دیگر استفاده از این زیرساخت هستند. استخراج اطلاعات از دادهها، خلاصهکردن متون طولانی و تبدیل حجم زیادی از اطلاعات به خروجیهای قابلاستفاده، از جمله کاربردهایی است که میتوان با کمک مدل زبانی در محصولات سازمانی و نرمافزارهای تخصصی به کار گرفت.
API؛ راهی برای استفاده از هوش مصنوعی بدون راهاندازی زیرساخت پردازشی اختصاصی
پیادهسازی قابلیتهای AI در یک محصول نرمافزاری، همیشه به معنای خرید GPU، نصب مدلهای زبانی بزرگ (LLM) و مدیریت زیرساخت پردازشی نیست.
یکی از روشهای دسترسی به مدلهای زبانی و سایر سرویسهای هوش مصنوعی، استفاده از API است. در این روش، توسعهدهنده میتواند از طریق یک رابط برنامهنویسی، درخواست خود را به مدل ارسال کند و پاسخ را در نرمافزار یا محصول خود دریافت کند.
برای مثال، یک فروشگاه اینترنتی میتواند از API برای طراحی دستیار پاسخگوی مشتریان استفاده کند. یک تیم نرمافزاری میتواند قابلیت تولید و بازبینی کد را به ابزار توسعه خود اضافه کند و یک مجموعه سازمانی نیز میتواند از مدلهای زبانی برای خلاصهسازی اسناد و استخراج اطلاعات بهره ببرد.
در این ساختار، تمرکز تیم فنی بهجای راهاندازی و نگهداری مستقیم مدل، روی توسعه محصول و طراحی تجربه کاربری قرار میگیرد.
سرویس API سپیدور با فراهمکردن دسترسی به مدلهای زبانی و APIهای هوش مصنوعی، این امکان را در اختیار توسعهدهندگان و کسبوکارها قرار میدهد تا قابلیتهای هوشمند را از طریق API در محصولات خود پیادهسازی کنند.
سپیدور؛ زیرساختی برای دسترسی سادهتر به مدلهای هوش مصنوعی
آمار چهار ماهه استفاده از API سپیدور، از ثبت نزدیک به ۵۰ میلیون درخواست و پردازش بیش از ۲۵۳ میلیارد توکن حکایت دارد. در این گزارش، دستیارهای گفتوگو، کدنویسی، تحلیل داده و خلاصهسازی اسناد از جمله حوزههای اصلی استفاده از مدلهای زبانی بودهاند.
این دادهها تصویری از کاربردهای متنوع هوش مصنوعی در فرایندهای نرمافزاری و کسبوکاری ارائه میکنند؛ کاربردهایی که برای پیادهسازی آنها، دسترسی به یک زیرساخت API قابلاستفاده اهمیت دارد.
سپیدور با ارائه سرویس APIaaS، امکان اتصال به مدلهای AI و استفاده از آنها را از طریق API فراهم میکند. به این ترتیب، توسعهدهندگان میتوانند بدون نیاز به تهیه و نگهداری GPU اختصاصی برای اجرای مدل، قابلیتهای AI را به محصولات و سرویسهای خود اضافه کنند.
API هوش مصنوعی را بدون پیچیدگی زیرساخت به محصول خود اضافه کنید
به مدلهای زبانی سپیدور متصل شوید و از همین امروز توسعه محصول هوشمند خود را شروع کنید.
- دسترسی به مدلهای متنباز و زبانی
- پرداخت بر اساس میزان مصرف توکن
- بدون نیاز به تهیه GPU اختصاصی
- امکان استفاده از API در نرمافزارها و محصولات مختلف